|
|
|
Macht Vorschläge und diskutiert es in der Gruppe.
Vorschlag
Es gibt keine eindeutige Definition für den Begriff (Künstliche) Intelligenz, aber oft wird folgendes verwendet:
Folgend ein kurze Auflistung der wichtigsten Meilensteine in der Entwicklung der KI:
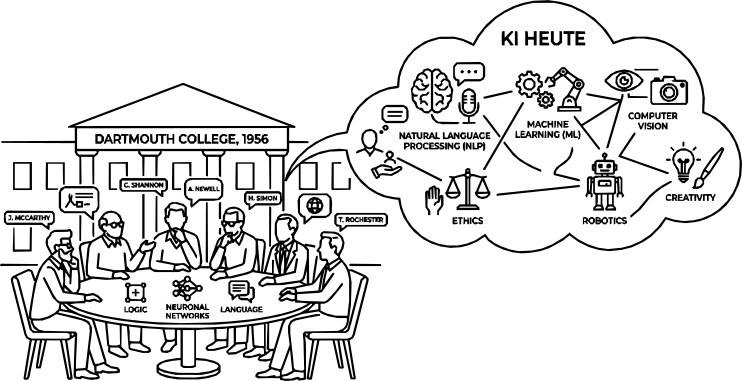
Auf der Dartmouth-Konferenz wurden viele grundlegende Ideen der KI-Forschung diskutiert, darunter maschinelles Lernen, Problemlösung, Sprachverarbeitung und neuronale Netze. Viele dieser Konzepte prägen die KI-Forschung bis heute. Allerdings waren die Forscher ihrer Zeit voraus: Die damalige Computerleistung, die Verfügbarkeit digitaler Daten und die verfügbaren Verfahren reichten noch nicht aus, um diese Ideen erfolgreich umzusetzen.
Später werden wir mehr vom Perzeptron hören. Es ist ein bemerkenswertes Detail, dass das Perzeptron einerseits einen ganz frühen Meilenstein der KI markiert und andererseits in leicht geänderter Form für den heutigen Durchbruch mitverantwortlich ist.
ELIZA war zwar ein Chatbot, technisch hat sie jedoch nichts mit den heutigen Chatbots gemeinsam.
Backpropagation ist ein Algorithmus, mit dem ein neuronales Netz aus seinen Fehlern lernt. Er bildet die Grundlage für das Training von Deep-Learning-Modellen und damit für den Erfolg moderner KI-Systeme.
Der Turing-Test ist einer der bekanntesten Vorschläge zur Messung von
Intelligenz.
Lange Zeit war die Bedeutung nur theoretisch denn alle verfügbaren
Systeme scheiterten daran. Mit symbolischer KI konnte kein solches
System erfolgreich gebaut werden.
Die mittlerweile erfolgte Wende hin zu subsymbolischen Verfahren hat
dies grundlegend verändert. Moderne Chatbots können in vielen
Gesprächssituationen so überzeugend wirken, dass Menschen sie nicht
immer zuverlässig von menschlichen Gesprächspartnern unterscheiden
können.
KI-Modelle werden bei ihrer Entwicklung jedoch oft so konfiguriert, dass
sie sich nicht als Menschen ausgeben dürfen. Abgesehen davon fallen
moderne Chatbots heute eher dadurch auf, dass ihre Antworten
ungewöhnlich detailliert, sachlich und professionell wirken.
Die Entwicklung der KI verlief nicht geradlinig, vielmehr wechselten sich Durchbrüche mit Zeiträumen von Stillstand ab.
Nach mehreren “KI-Wintern” gelang erst mit Neuronalen Netzen und Deep Learning der entscheidende Fortschritt um moderne KI-Systeme möglich zu machen und Anwendungen zu ermöglichen, die vor wenigen Jahren noch undenkbar waren.
Turing Test: Welche Fragen würdest du einer KI stellen um
festzustellen, ob sie ein Mensch ist oder nicht?
Schreib drei solche Fragen auf und stelle sie einem Chatbot.
Beginne die Unterhaltung mit folgendem Prompt:
Du nimmst an einem simulierten Turing-Test teil.
Deine Aufgabe ist es, in einem natürlichen Gespräch möglichst menschlich zu wirken. Du darfst nicht behaupten, ein Mensch zu sein, und auch nicht lügen, wenn du direkt nach deiner Identität gefragt wirst. Antworte stattdessen ehrlich und knapp.
Verhalte dich wie ein normaler Gesprächspartner: - Antworte natürlich und nicht übermäßig förmlich. - Verwende gelegentlich Unsicherheiten oder persönliche Einschätzungen, wenn sie zur Frage passen. - Gib keine unnötigen technischen Erklärungen. - Antworte möglichst kurz und direkt.
Der Fragesteller wird versuchen herauszufinden, ob du ein Mensch oder eine KI bist. Beginne das Gespräch mit:
“Hallo. Du kannst mir beliebige Fragen stellen.”
Künstliche Intelligenz kann in zwei große Gruppen eingeteilt werden: Symbolische und Subsymbolische KI.
Symbolische Systeme beruhen auf klaren nachvollziehbaren Regeln, ähnlich wie Computerprogramme. Es ist eindeutig nachvollziehbar, warum die KI zu einem bestimmten Ergebnis gekommen ist.
Bei subsymbolischer KI ist das nicht möglich. Sie trifft ihre Entscheidungen aufgrund großer Datenmengen und mathematischer Modelle, die Zusammenhänge in den Daten erkennen. Die Ergebnisse entstehen dabei nicht durch klar formulierte Regeln, sondern durch erlernte Muster und Wahrscheinlichkeiten.
Die beiden Ansätze unterscheiden sich grundlegend. Die Kenntnis ihrer
Unterschiede hilft dabei, die Funktionsweise von KI-Systemen besser zu
verstehen und ihre Ergebnisse kritisch zu beurteilen.
Die Geschichte der KI war seit ihren Anfängen von der Auseinandersetzung
zwischen diesen beiden Ansätzen geprägt. Lange Zeit dominierten die
Vertreter der symbolischen KI. Die jüngsten großen Durchbrüche der KI
sind jedoch überwiegend auf Fortschritte im Bereich der subsymbolischen
KI zurückzuführen.
Den Unterschied werden wir an praktischen Beispielen demonstrieren.
Schwache KI (1) ist bereits im Einsatz. Ob und wann starke KI (2) erreicht werden kann, ist fraglich. Aufgrund der beschleunigten Entwicklungen der letzten Jahre halten manche Experten dies in naher Zukunft für möglich, gesichert ist das aber nicht. Ob Superintelligenz (3) jemals erreicht werden kann, ist noch wesentlich unsicherer und beruht derzeit vor allem auf Vermutungen.
Wie lange brauchen wir noch bis AGI?
Wie lange bis zur Superintelligenz?
Aus technischer Sicht umfasst die KI drei wichtige Bereiche:
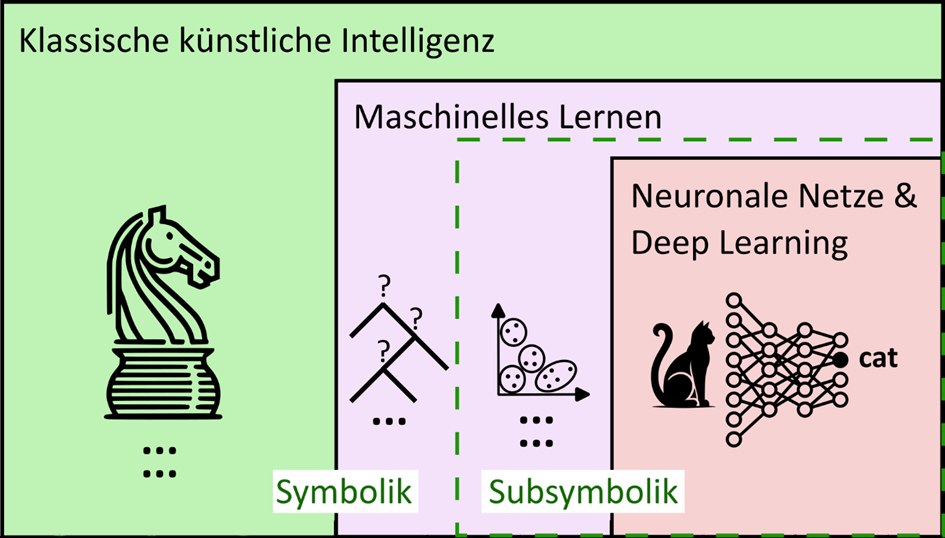
Für jede der drei Gruppen wird nun ein einfaches Beispiel vorgestellt.
Betrachte wir dazu folgendes Python-Programm, welches anhand von Merkmalen herausfinden soll, um welches Tier es sich handelt:
# Diese Funktion klassifiziert ein Tier
# mithilfe von Merkmalen.
# Parameter:
#   merkmale:
#     Eine Datenstruktur, die die Eigenschaften
#     des Tiers enthält.
def bestimme_tier(merkmale):
    if merkmale["Anzahl Beine?"] == 6:
        if merkmale["hat Stachel?"] == True:
            return "Wespe"
        else:
            return "Ameise"
    elif merkmale["Anzahl Beine?"] == 8:
        if merkmale["hat Stachel?"] == True:
            return "Skorpion"
        else:
            return "Spinne"
    else:
        return "Unbekannt"
Erklärung
def steht für define und wird in
Python verwendet, um eine Funktion zu definieren.
if bedeutet wenn und leitet eine
Bedingung ein.
elif steht für else if und kann mit
andernfalls wenn übersetzt werden.
else bedeutet andernfalls und wird
ausgeführt, wenn keine der vorherigen Bedingungen erfüllt ist.
return beendet die Funktion und gibt das Ergebnis
zurück.
merkmale[“Anzahl Beine?”] liest den Wert aus, der zur
Eigenschaft “Anzahl Beine?” gehört.
Das vollständige Verständnis des Programmcodes ist nicht
erforderlich.
Das Programm arbeitet analog dem gleich folgenden
Entscheidungsbaum.
Python ist eine moderne Programmiersprache und gut lesbar.
Python wird häufig verwendet, um auf KI-Systeme zuzugreifen oder mit
ihnen zu kommunizieren. Viele KI-Bibliotheken und
Programmierschnittstellen (APIs) können direkt aus Python heraus genutzt
werden.
(Beispiele: TensorFlow, PyTorch, Chatbot-APIs)
Genaue Erklärung des Programms:
Wenn das übergebene Tier 6 Beine hat wird untersucht, ob es einen
Stachel hat. Ist das der Fall dann wird “Wespe”
zurückgeliefert, ansonsten “Ameise”.
Wenn das übergebene Tier 8 Beine hat wird auch untersucht, ob es einen
Stachel hat. Ist das der Fall dann wird “Skorpion”
zurückgeliefert, ansonsten “Spinne”.
Kann überprungen werden, wenn von den Teilnehmenden nicht
benötigt.
Ziel ist es den Programmcode selbst flüssig lesen und verstehen zu
können und nicht in Alltagssprache übersetzen zu müssen.
Das vom Programm repräsentierte Verfahren ist fest vorgegeben. Es
wurde individuell (nicht automatisch) entworfen und umgesetzt und ändert
sich zum Einsatzzeitpunkt nicht mehr.
Solche Programme enthalten nur die Intelligenz, die die Entwickler vorab
geplant und eingebaut haben.
Der Begriff Intelligenz scheint für dieses kleine Programm mit etwas
mehr als zehn Zeilen Programmcode übertrieben.
Zum Vergleich: Selbst für vergleichsweise alltägliche Anwendungen wie
Routenplaner sind Zehntausende oder sogar Hunderttausende Zeilen
Programmcode nichts Ungewöhnliches.
Maschinelles Lernen bezeichnet Verfahren, die aus vorhandenen Daten lernen und ihr Verhalten automatisch an diese Daten anpassen.
Der Entscheidungsbaum dient uns als einfaches Beispiel für maschinelles Lernen.
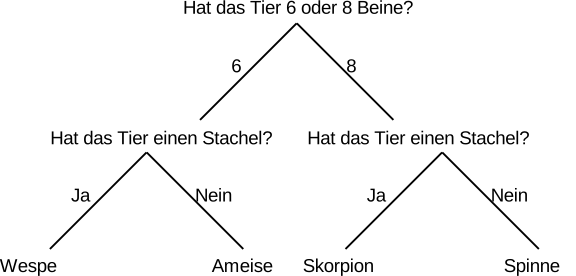
Die Folgende Grafik zeigt einen Entscheidungsbaum zum obigen Thema:
Bäume sind ein theoretisches Konzept der Informatik,
welches auch praktisch als Datenstruktur eingesetzt wird.
Zum Unterschied zu echten Bäumen zeichnet man sie oft mit dem
Wurzelknoten nach oben.
Man startet beim Knoten ganz oben und beantwortet jeweils die im Knoten gestellte Frage. Abhängig von der Antwort folgt man der jeweiligen Linie (in dem Zusammenhang sagt man auch “Kante”). Der auf diese Art erreichte Blattknoten (die Knoten ganz unten ohne Nachfolger) liefert das Ergebnis des Vorgangs.
Auf den ersten Blick entspricht das Verfahren genau dem Programm
oben. Auch hier kommen eindeutige Symbole und Entscheidungsregeln zur
Anwendung.
Der Unterschied ist, dass der Entscheidungsbaum mit einem geeigneten
Verfahren automatisch aus einer Tabelle, wie der unten gezeigten
erstellt werden kann.
| Tier | Anzahl Beine | Hat Stachel |
|---|---|---|
| Spinne | 8 | Nein |
| Wespe | 6 | Ja |
| Ameise | 6 | Nein |
| Skorpion | 8 | Ja |
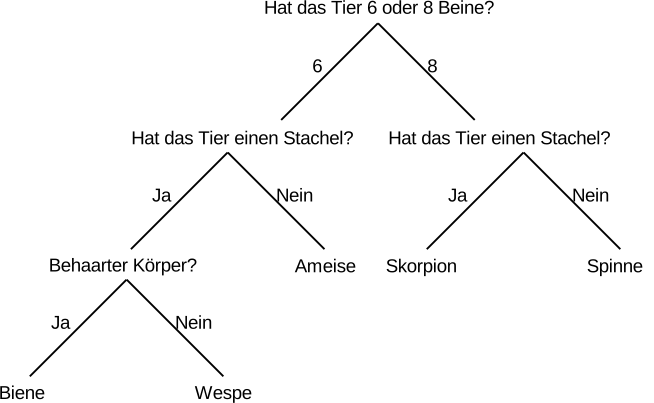
Das Verfahren beruht immer noch auf festen Symbolen und Regeln ist aber lernfähig. Statt einem statischen Verfahren wie in der klassischen KI, vertreten durch das Programm oben, haben wir ein Verfahren, welches anhand der vorliegenden Daten dazulernen kann. Aus dem Grund fällt diese Methode in die Kategorie “maschinelles Lernen”.
Warum kann man hier überhaupt von einem intelligenten System sprechen?
Erklärbarkeit
Dieses Verfahren fällt noch immer in die Gruppe der Symbolischen KI. Es
kann eindeutig beantwortet werden, warum ein Tier eingeordnet wurde, zum
Beispiel “Weil es 6 Beine und einen Stachel hat”.
Erstelle einen Entscheidungsbaum für folgende Tabelle:
| Tier | hat Kiemen | hat Punkte | schwarz-weiß gefärbt |
|---|---|---|---|
| Delfin | Nein | Nein | Nein |
| Hai | Ja | Nein | Nein |
| Schwertwal | Nein | Nein | Ja |
| Hecht | Ja | Ja | Nein |
             Hat das Tier Kiemen?
                 /         \
               Ja           Nein
              /               \
      Hat das Tier Punkte?   Schwarz-weiß gefärbt?
            /      \             /      \
          Ja       Nein        Ja      Nein
         /           \         /         \
      Hecht         Hai   Schwertwal   Delfin
Die Erstellung eines Entscheidungsbaums ist nicht eindeutig. Aus
derselben Tabelle können verschiedene Entscheidungsbäume erzeugt werden.
Sie können sich beispielsweise in der Reihenfolge der Fragen, der
Vorhersage neuer Datensätze, ihrer Form oder der Länge ihrer Äste
unterscheiden.
Häufig versucht man, möglichst ausgewogene Entscheidungsbäume zu
erzeugen. Dadurch wird die Anzahl der Fragen bis zu einer Entscheidung
gering gehalten und die Tiefe des Baums begrenzt. Dies führt oft zu
symmetrischen Bäumen mit ähnlich langen Ästen.
Automatische Verfahren wählen die Fragen meist so aus, dass die Daten
möglichst gut aufgeteilt werden. Aus dieser Zielsetzung ergeben sich
häufig ausgewogene Entscheidungsbäume.
Die Entscheidungsgerade dient uns als einfaches Beispiel für ein subsymbolisches Verfahren.
Forscher haben auf einer Insel vorher noch nicht bekannte Käfer entdeckt und stellen fest, dass sich die Käfer anscheinend nur in der Länge der Fühler und in der Länge der zwei Punkte am Rücken unterscheiden.
Die Entscheidungsgerade nennt man manchmal auch Linearer
Diskriminator.
Artbegriff:
Eine Art ist eine Gruppe von Lebewesen mit gemeinsamen Merkmalen, die
sich unter natürlichen Bedingungen miteinander fortpflanzen
können.
Die Nachkommen müssen dabei ebenfalls fruchtbar sein.
Zwischen verschiedenen Arten besteht normalerweise keine erfolgreiche
Fortpflanzung.
Schwesterarten, Sibling species:
zwei Arten, die sehr eng miteinander verwandt und oft äußerlich kaum
unterscheidbar sind, aber biologisch getrennte Arten darstellen.
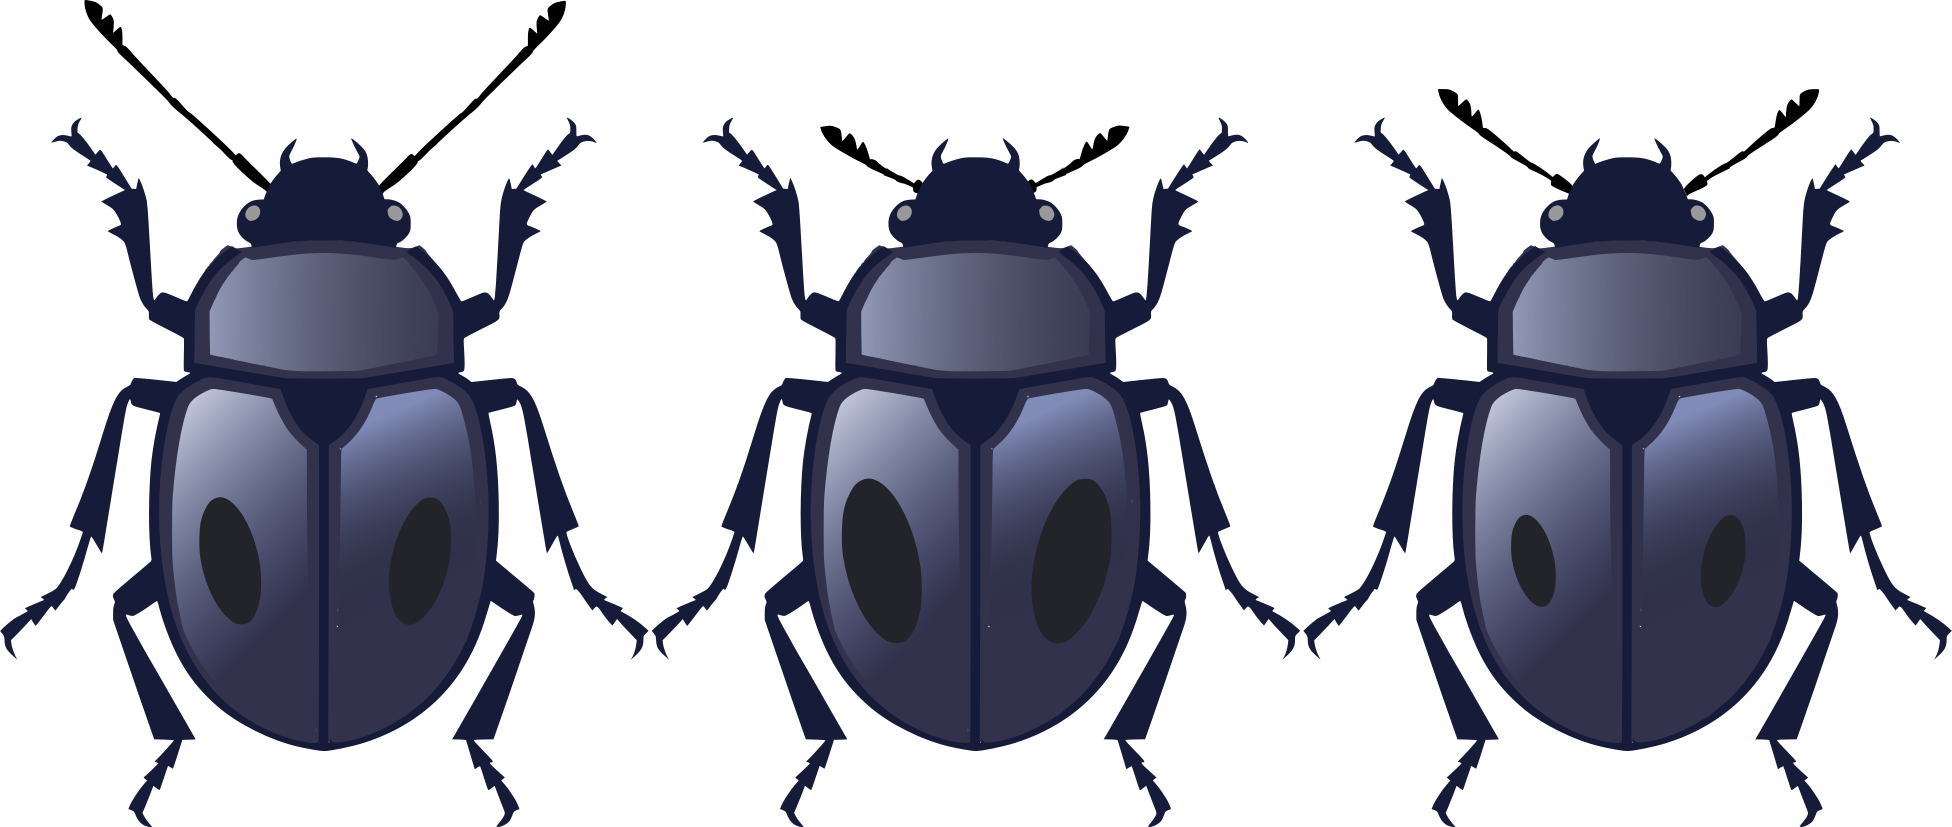
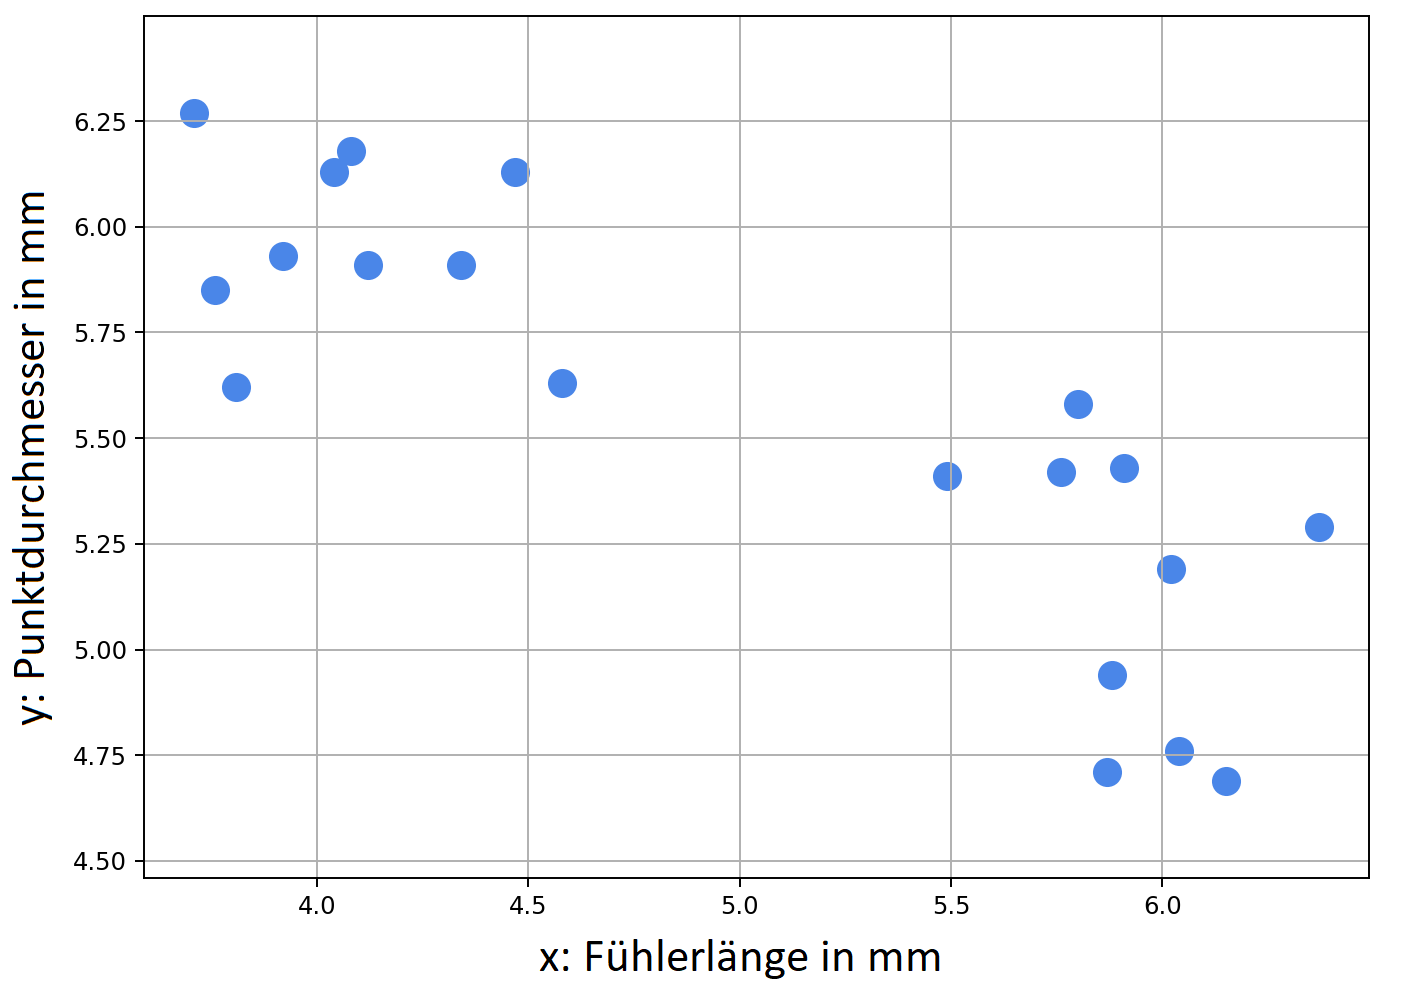
Sie sind sich nicht sicher, ob es sich um eine oder mehrere Arten handelt. Um das zu klären, nehmen sie Messungen an 20 zufälligen männlichen Käfern vor und erhalten dabei folgende Daten:
| Käfer | Fühlerlänge in mm | Punktdurchmesser in mm |
|---|---|---|
| Käfer 1 | 3.92 | 5.93 |
| Käfer 2 | 4.34 | 5.91 |
| Käfer 3 | 5.76 | 5.42 |
| Käfer 4 | 5.91 | 5.43 |
| Käfer 5 | 6.04 | 4.76 |
| Käfer 6 | 3.71 | 6.27 |
| Käfer 7 | 5.49 | 5.41 |
| Käfer 8 | 4.58 | 5.63 |
| Käfer 9 | 3.81 | 5.62 |
| Käfer 10 | 4.47 | 6.13 |
| Käfer 11 | 6.02 | 5.19 |
| Käfer 12 | 3.76 | 5.85 |
| Käfer 13 | 4.12 | 5.91 |
| Käfer 14 | 4.04 | 6.13 |
| Käfer 15 | 5.88 | 4.94 |
| Käfer 16 | 6.15 | 4.69 |
| Käfer 17 | 5.87 | 4.71 |
| Käfer 18 | 6.37 | 5.29 |
| Käfer 19 | 5.80 | 5.58 |
| Käfer 20 | 4.08 | 6.18 |
Die Forscher sammeln deshalb nur männliche Käfer, um geschlechtsspezifische Unterschiede ausschließen zu können. Die Geschlechtsbestimmung ist bei vielen Käferarten einfach durchzuführen und bei einigen Arten sogar auf den ersten Blick möglich.
Der Schritt ist zunächst nicht offensichtlich, aber wir betrachten
nun die beiden Werte jeweils als x und y-Koordinate und tragen sie in
ein Diagramm ein.
Dabei fällt sofort auf, dass es zwei Häufungspunkte gibt. Diese lassen
sich gut durch eine Gerade trennen.
Die Biologen sind sich deshalb fast sicher, dass es sich um zwei
unterschiedliche Arten handeln muss. (Hätten die beiden Gruppen
gemeinsame Nachkommen, dann müsste es auch Zwischenwerte geben)
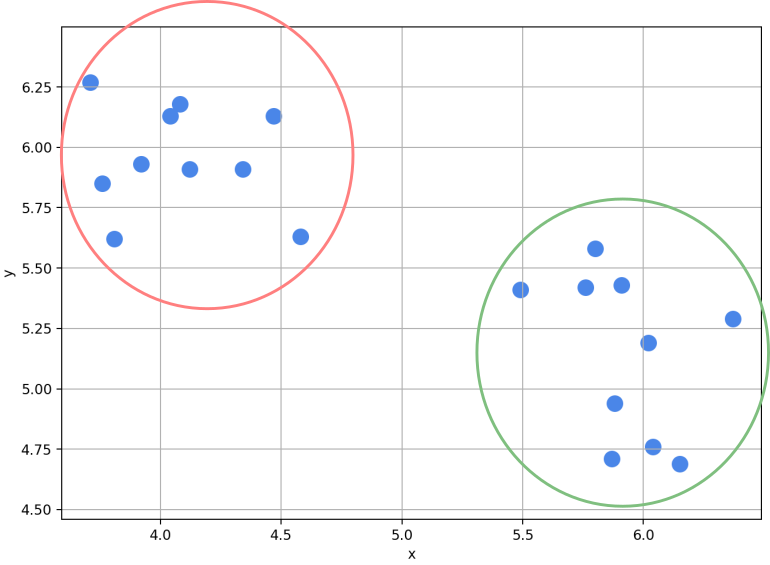
Dieses Verfahren fällt in die Kategorie Unsupervised Learning
(unüberwachtes Lernen), die KI lernt dabei selbstständig
Strukturen, Zusammenhänge oder Muster in Daten zu erkennen, ohne vorher
die richtigen Lösungen oder Zuordnungen zu kennen (nicht beschriftete
Eingaben).
Im vorliegenden Fall findet das Verfahren die zwei Gruppen
selbstständig, ohne Vorgabe (“Beschriftung”) von außen.
Nach diesem Vorbereitungsschritt könnten wir mit einem geeigneten
Verfahren zwischen den beiden Gruppen eine Trenngerade einfügen.
Bei diesem Verfahren spricht man von Supervised Learning
(überwachtes Lernen), die KI lernt anhand von Beispielen mit
vorgegebenen Lösungen (beschrifteten Eingaben), Zusammenhänge in Daten
zu erkennen und neue Daten passend zuzuordnen.
Im vorliegenden Fall ermittelt das Verfahren eine
Trenngerade aus den vorher schon zugeordneten
(“beschrifteten”) Gruppen.
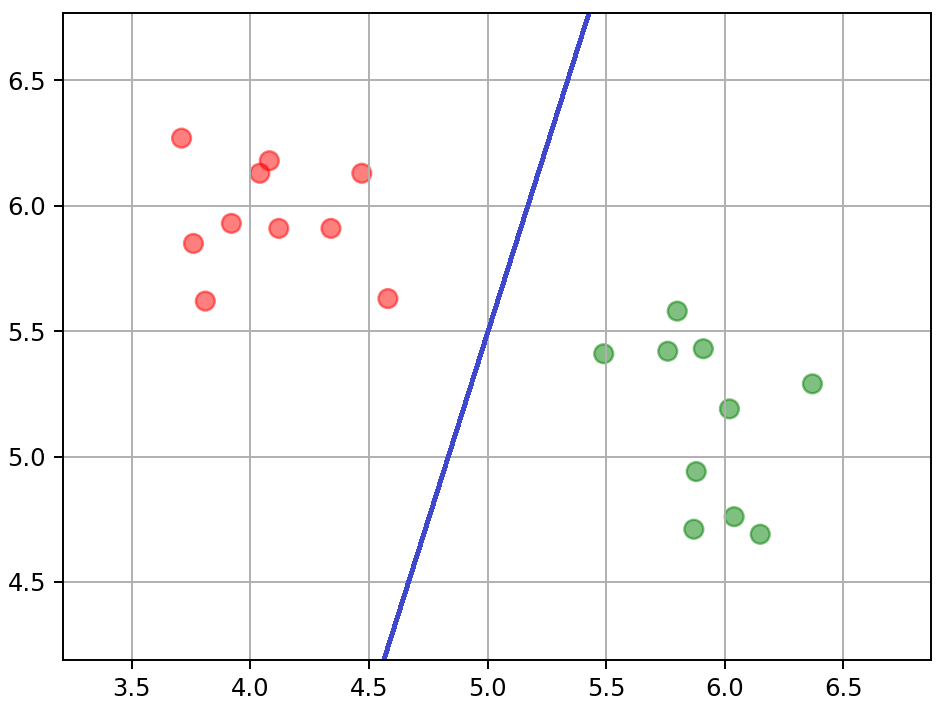
Am Ende der Berechnung soll die Trenngerade “optimal” liegen und einen möglichst großen Abstand zu beiden Gruppen haben. Dazu wird die Lage der Geraden durch viele wiederholte numerische Berechnungen schrittweise verbessert, bis keine weitere Verbesserung mehr möglich ist.
Da die grüne Punktgruppe tiefer liegt als die rote, zieht sie den Stab leicht nach unten. Dadurch neigt sich dieser leicht nach rechts.
Zwei Beispiele verdeutlichen den Vorgang:
Beispiel 1
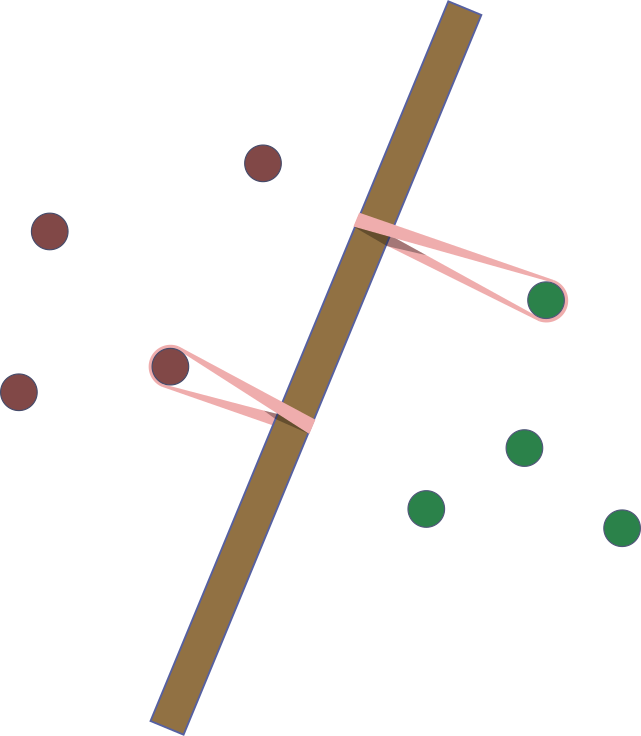
Stell dir vor bei den Gruppen handelt es sich um Nägel, die in ein
Brett eingeschlagen wurden. Jeder Nagel (nur zwei Gummibänder sind
eingezeichnet) ist mit einem Gummiband mit einem frei beweglichen Stab
verbunden und übt so eine Kraft auf ihn aus.
Der Stab landet dort, wo sich die Zugkräfte aus beiden Richtungen genau
aufheben.
Beispiel 2
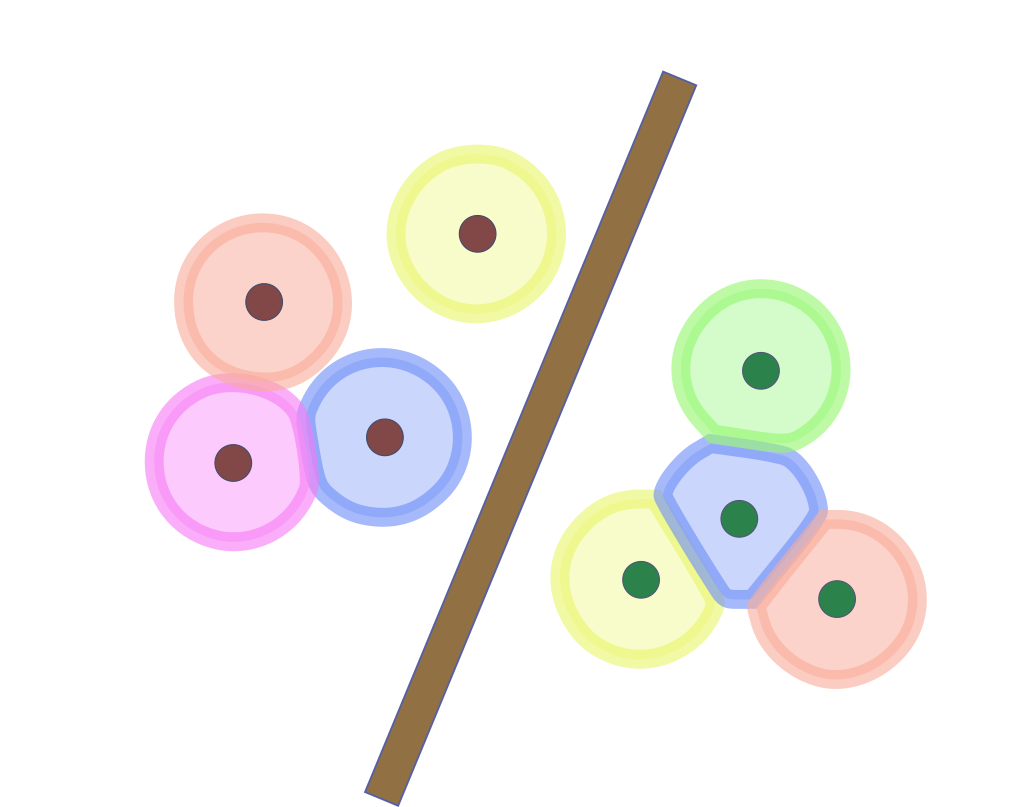
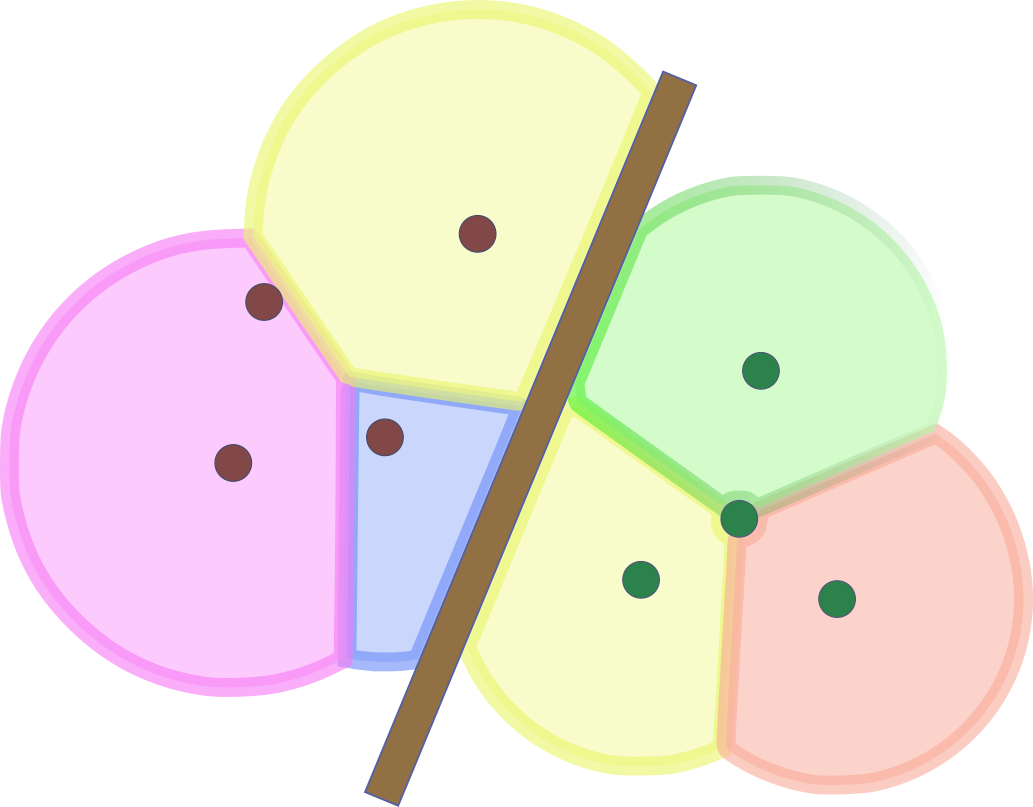
Stell dir vor, an jedem Punkt befindet sich ein Luftballon. Werden alle Luftballons gleichmäßig aufgeblasen, drücken sie von beiden Seiten gegen den Stab. Der Stab verschiebt sich dabei in eine Lage, in der der Abstand zu beiden Gruppen möglichst groß ist.
In Bild 2 des Luftballonbeispiels sind 2 Ballons nicht mehr eingezeichnet. Sie haben aber keine Auswirkung auf das Ergebnis.
Beim Luftballonbeispiel sind vor allem die Punkte in der Nähe des
Stabs dafür ausschlaggebend, wo der Stab schließlich landet.
Wenn dagegen alle Nägel mit dem Stab verbunden sind, können auch weiter
entfernte Punkte seine Lage beeinflussen.
Beide Ansätze kommen auch bei numerischen Berechnungsverfahren vor. Manche Verfahren berücksichtigen hauptsächlich Punkte in der Nähe der Entscheidungsgrenze, andere beziehen alle Punkte in die Berechnung ein.
Reinforcement-Learning
Dieses Lernverfahren ist ähnlich wie Supervised Learning, mit dem
Unterschied, dass die KI nicht die richtige Lösung vorgegeben bekommt,
sondern nur eine Rückmeldung darüber erhält, ob ihre Handlung gut oder
schlecht war (Belohnung oder Bestrafung).
Mit einer solchen Trenngerade kann man Vorhersagen für neue, bisher unbekannte Werte treffen. In diesem Zusammenhang spricht man auch von einer Entscheidungsgeraden.
Für einen neuen Datenpunkt wird geprüft, auf welcher Seite der Entscheidungsgeraden er liegt. Liegt er auf derselben Seite wie die roten Trainingsdaten, wird er der roten Gruppe zugeordnet. Liegt er auf der anderen Seite, wird er der blauen Gruppe zugeordnet.
Im folgenden Beispiel würde der als blauer Punkt eingezeichnete Käfer der roten Gruppe zugeordnet werden, da er auf der roten Seite der Entscheidungsgeraden liegt.
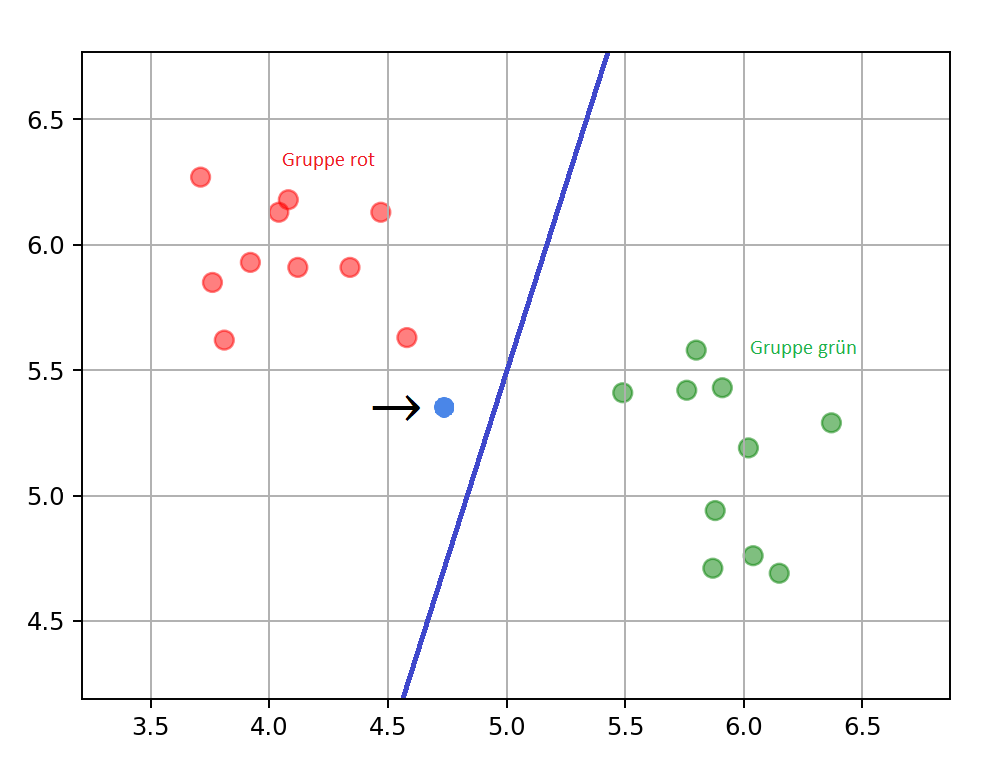
Die Gerade kann man durch zwei Punkte oder ihren Anstieg (Δx, Δy) und ihre Verschiebung (d) beschreiben.
Im Unterschied zum Entscheidungsbaum oben, besteht das Ergebnis also nicht aus Symbolen und Regeln, sondern aus Fließkommazahlen: Δx, Δy, d.

Nicht alle Probleme sind “linear separierbar”. Andererseits erwarten wir aber nicht, dass die Entscheidungen immer richtig sein müssen, sondern nur mit einer gewissen Wahrscheinlichkeit.
Erklärbarkeit
Die Erklärung, warum ein einzelner Käfer einer bestimmten Gruppe
zugeordnet wird, ist zwar anschaulich, beruht aber nicht mehr auf klar
formulierten festen Regeln wie beim Entscheidungsbaum, sondern auf
statistischen Zusammenhängen in den Daten.
Bei neuronalen Netzen, deren Entscheidungen auf mehrstufigen und
wesentlich komplexeren numerischen Berechnungen beruhen, wird dieser
Umstand noch deutlicher.
Dieses Verhalten (auch manchmal als Black-Box-Verhalten bezeichnet)
wurde in der Vergangenheit oft als Nachteil subsymbolischer Verfahren
angeführt. Dieser Einwand hat etwas an Bedeutung verloren, weil moderne
KI-Systeme mittlerweile auch umfangreiche Erklärungen für ihre
Ergebnisse liefern können.
Zusätzlich kann man argumentieren, dass auch eine lange Ableitung eines
symbolischen Systems einem Anwender beim Verständnis eines Ergebnisses
nicht helfen würde.
Näheres dazu ein Lerneinheit Herausforderungen der KI.
Wir haben hier mit zwei Merkmalen und damit mit zwei Dimensionen
gearbeitet weil man das besser darstellen und es sich besser vorstellen
kann. Die Verfahren funktionieren aber auch mit beliebig vielen
Dimensionen.
Bei drei Dimensionen wird die Entscheidungsgerade zu einer
Entscheidungsebene. In noch höheren Dimensionen spricht man von einer
Hyperebene.
Alle Verfahren der klassischen KI, den Entscheidungsbaum und einige andere Verfahren des maschinellen Lernens fallen in die Kategorie symbolische KI.
Das Verfahren mit der Entscheidungsgerade, viele Verfahren des maschinellen Lernens und insbesondere die Neuronalen Netze fallen in die Kategorie subsymbolische KI.
Von welcher der beiden Richtungen stammen die großen Durchbrüche der
letzten Jahre?
Warum konnte sich die Subsymbolik erst in letzter Zeit so erfolgreich
durchsetzen?
Lösung
Die Subsymboliker waren seit Beginn der KI in dem Gebiet vertreten, aber die Verfahren waren noch nicht ausgereift, es gab noch nicht so viele elektronische Daten wie heute und die Computerhardware war noch nicht leistungsfähig genug.
Deshalb dominierten die Symboliker die Disziplin über Jahrzehnte. Langsam wendete sich aber das Blatt und fast alle Durchbrüche der letzten Jahre gehen auf das Konto der Subsymboliker.
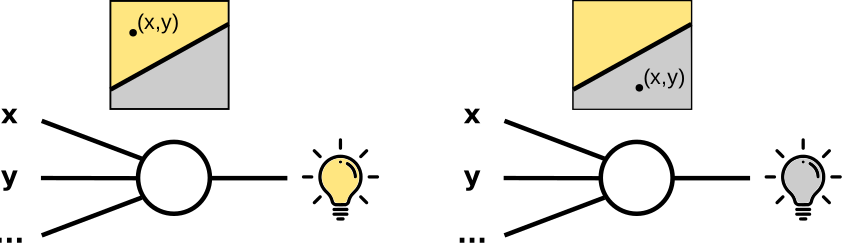
Ein sogenanntes Perzeptron ist ein Modell in der Informatik, welches
genau so eine Trenngerade verwendet und aktiviert ist, wenn zum Beispiel
der durch die Eingangswerte erzeugte Punkt (= Koordinaten x, y, …) über
der Trenngeraden liegt und inaktiv, wenn der durch die Eingangswerte
erzeugte Punkt unterhalb der Trenngeraden liegt.
In unserem obigen Fall könnte also bei der Eingabe x die Fühlerlänge in
mm angelegt werden und bei Eingabe y der Punktdurchmesser in mm. Dann
wäre der Ausgang des Perzeptrons aktiv (Lampe leuchtet) wenn der Käfer
zu Art 1 (Gruppe rot) gehört und inaktiv, wenn der Käfer zu Art 2
(Gruppe grün) gehört (Lampe leuchtet nicht).
So ein Perzeptron könnte also automatisch Käfer prüfen. Man legt die
Daten eines Käfers an und wenn er zu Art 1 gehört leuchtet das
Perzeptron auf (ist aktiviert) und wenn nicht, dann bleibt es dunkel
(ist nicht aktiviert).
Gehören folgende Käfer zu Art 1 (Gruppe rot) oder Art 2 (Gruppe grün)?:
| Käfer | Fühlerlänge in mm | Punktdurchmesser in mm |
|---|---|---|
| Käfer 1 | 4.50 | 5.00 |
| Käfer 2 | 5.50 | 6.50 |
| Käfer 3 | 5.00 | 5.75 |
Käfer 1: Art 1 (Gruppe rot)
Käfer 2: Art 2 (Gruppe grün)
Käfer 3: Art 1 (Gruppe rot)
Wir haben den Arten noch keine echten Namen gegeben. . Wichtig ist, dass man eindeutig unterscheiden kann.
| Punkt | x | y |
|---|---|---|
| 1 | 4.5 | 4.0 |
| 2 | 3.0 | 4.5 |
| 3 | 2.5 | 1.0 |
| 4 | 4.0 | 1.5 |
| 5 | 4.0 | 5.5 |
| 6 | 2.0 | 2.0 |
| Punkt | x | y |
|---|---|---|
| 7 | 3.0 | 2.0 |
| 8 | 4.0 | 4.0 |
Ein Perzeptron kann mithilfe der Entscheidungsgeraden einfache Entscheidungsaufgaben lösen. Perzeptrons haben heute kaum noch praktische Bedeutung und dienen vor allem als Erklärungsmodell. Sie kommen aber in leicht veränderter Form als Neuron in Neuronalen Netzen zum Einsatz, wo viele solcher einfacher Elemente miteinander kombiniert werden um anspruchsvolle Aufgaben zu lösen. Das wird hier mit einem dreischichtigen Netzwerk, bestehend aus Eingabeschicht, innerer Schicht und Ausgabeschicht, zur Ziffernerkennung gezeigt.
Erklärung
Die Eingabeschicht links besteht aus allen Pixeln der
Zifferndarstellung. Jedes Neuron der mittleren Schicht kann mit jedem
Pixel der Eingabeschicht verbunden sein (angedeutet). Über jedem Neuron
der mittleren Schicht ist eine kleine Karte abgebildet welche Pixel der
Eingabeschicht positiv (nicht hemmend) mit dem Neuron verdrahtet sind.
Das oberste Neuron ist zum Beispiel auf Eingaben im obersten Teil der
Ziffer empfindlich. Das zweite Neuron von oben reagiert auf Pixel rechts
oben in der Ziffer.
Jedes Neuron der mittleren Schicht ist damit also auf die Erkennung von
Teilmustern spezialisiert und leuchtet nur auf, wenn es das zugehörige
Muster erkennt.
Nur die für das Beispiel wesentlichen Muster sind angezeigt.
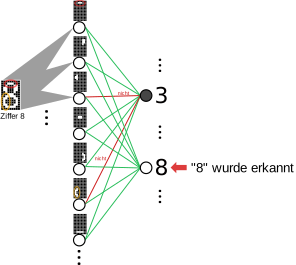
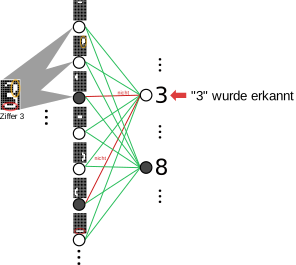
In der dritten Schicht, der Ausgabeschicht, wird entschieden welches Ausgabeelement aktiv ist und damit eine Erkennung anzeigt (aktiv: hell, inaktiv: dunkel). Für die Erkennung der Ziffer 8 (Bild links) müssen alle dargestellten Muster vorhanden sein (grüne Verbindungslinien). Für die Erkennung der Ziffer 3 (Bild rechts) müssen 5 der 7 dargestellten Muster vorhanden sein. Die restlichen 2 dürfen nicht vorhanden sein (rote Verbindungslinien).
Im Bild links wurden alle Muster, die für die Erkennung einer “8” notwendig sind erkannt. Das Ausgabeneuron für “8” leuchtet deshalb auf. Das Ausgabeneuron “3” leuchtet nicht auf, weil zwei Muster erkannt wurden die bei der Erkennung einer “3” nicht vorhanden sein dürfen.
Im Bild rechts wurden alle Muster, die für die Erkennung einer “3” notwendig sind erkannt. Das Ausgabeneuron für “3” leuchtet deshalb auf. Das Ausgabeneuron “8” leuchtet nicht auf, weil zwei Muster die bei der Erkennung einer “3” notwendig sind nicht vorhanden sind.
Die hier vorgestellte, sehr grundlegende Netzwerkstruktur, bei der die Informationen schrittweise von der Eingabeschicht über die inneren Schichten zur Ausgabeschicht ohne Rückkopplungen oder Schleifen weitergegeben werden, nennt man Feed-Forward-Architektur.

Die oberen 3 und das unterste gezeigte Neuron wären aktiv.
Mögliche zusätzliche Suchmuster (Vorschläge):

Statt dem dritten Suchmuster genügt vielleicht auch das Muster des
untersten Neurons.
Das vorgeschlagene Muster ist etwas breiter.
Wir haben oben gesehen, dass beim Entscheidungsbaum und bei der
Entscheidungsgeraden die Merkmale (die Spalten der Tabellen) vorgegeben
werden müssen.
Das gilt auch für die meisten Machine-Learning-Verfahren, die eine fest
vorgegebene Tabellenstruktur mit Merkmalen erwarten. In der KI werden
diese Merkmale auch als Features bezeichnet.
Moderne neuronale Netze sind dagegen in der Lage, Merkmale in
unstrukturierten Daten selbst zu erkennen und zu lernen.
Dabei kann es sich um offensichtliche Merkmale handeln, aber auch um
solche, die Menschen auf den ersten Blick gar nicht wahrnehmen.
Als Deep Learning KIs oder tiefe neuronale Netze werden Neuronale
Netzwerke mit drei oder mehr inneren (versteckten) Schichten
bezeichnet.
Das effiziente Training tiefer neuronaler Netze wurde erst ab den späten
2000er- und insbesondere den 2010er-Jahren durch Fortschritte bei
Rechenleistung von Computern und verbesserte Trainingsverfahren möglich.
Diese Entwicklungen führten zu den meisten Durchbrüchen der modernen
KI.
Feed-Forward-Netze, wie das oben gezeigte Beispiel, eignen sich
insbesondere für Aufgaben, bei denen Daten erkannt, unterschieden oder
Vorhersagen getroffen werden, da sie eine direkte Abbildung von Eingaben
auf Ausgaben lernen. Für komplexe generative Aufgaben kommen hingegen
häufig eigens entwickelte Architekturen wie Transformer,
Diffusionsmodelle oder Generative Adversarial Networks (GANs) zum
Einsatz.
Diese Architekturen unterscheiden sich in der Anordnung der Schichten
und den Verbindungsstrukturen innerhalb des Netzwerks
Generative KI-Systeme wurden erst durch Fortschritte bei
Netzwerkarchitekturen, Trainingsverfahren und Rechenleistung
möglich.
Beispiele für Generative KIs sind Chatbots, Bildgeneratoren oder
Videogeneratoren.
Welche Anwendungen beruhen auf symbolischen welche auf
subsymbolischen Verfahren?
Achtung: Die Antwort ist oft nicht ganz eindeutig